XPath é uma linguagem de caminhos para XML, e o .NET a expõe por meio de dois métodos de XmlNode: SelectSingleNode() retorna o primeiro nó que corresponde a uma expressão, e SelectNodes() retorna todos eles.
Uma expressão se lê como um caminho de arquivo. /catalog/book desce a partir da raiz, //book encontra livros em qualquer profundidade e um predicado entre colchetes filtra o que um passo retornou, como em /catalog/book[price<50.00].
Visão geral do XML
XML (eXtensible Markup Language), como o nome sugere, é uma linguagem de marcação. Ela usa uma organização hierárquica para descrever e armazenar dados.
Outra característica da linguagem XML é que ela não tem tags predefinidas, e os usuários criam as suas próprias. O número de tags também é ilimitado. Dessa forma, o XML é flexível e adequado para descrever qualquer tipo de informação.
Sintaxe do XML
O documento XML tem um modelo hierárquico composto por um elemento raiz, o elemento de nível mais alto, e suas ramificações.
Podemos definir um elemento como tudo o que está entre uma tag de abertura (<tagName>) e a respectiva tag de fechamento (</tagName>), incluindo as próprias tags. Cada um desses blocos de construção pode conter texto, atributos ou até outros elementos aninhados:
<?xml version="1.0" encoding="utf-8" ?>
<catalog>
  <book id="1">
    <author>King, Stephen</author>
    <title>IT</title>
    <genre>Horror</genre>
    <price>40.00</price>
  </book>
  <book id="2">
    <author>Assis, Machado De</author>
    <title>Dom Casmurro</title>
    <genre>Romance</genre>
    <price>50.00</price>
  </book>
  <book id="3">
    <author>Calaprice, Alice; Lipscombe, Trevor</author>
    <title>Albert Einstein: A Biography</title>
    <genre>Biography</genre>
    <price>30.00</price>
  </book>
  <book id="4" xmlns="urn:example-schema">
    <author>Fowler, Martin; Beck, Kent</author>
    <title>Refactoring: Improving the design of existing code</title>
    <genre>Scientific</genre>
    <price>60.00</price>
  </book>
</catalog>
Neste exemplo, temos um arquivo XML que representa um catálogo de books, em que catalog é o elemento raiz e contém todas as informações que vamos manipular.
Em cada livro, author, title, genre e price são representados por elementos aninhados dentro da tag pai book. Essa estrutura usa um atributo para definir o índice de cada book.
Os elementos de nível mais baixo, como author, têm seus valores representados por texto, uma string colocada entre as tags de abertura e de fechamento.
O que é XPath e com qual versão o .NET é compatível?
XPath é uma linguagem de consulta para XML. Uma expressão descreve um caminho pela árvore do documento, e o .NET a avalia em relação a um documento carregado e retorna os nós que ela encontrou.
A sintaxe se lê como um caminho de arquivo. Um / inicial começa na raiz, // busca em qualquer profundidade, um nome desce um nível e @ acessa um atributo. Colchetes contêm um predicado que filtra o que o passo imediatamente anterior retornou.
O .NET implementa XPath 1.0, e apenas XPath 1.0. A referência da Microsoft para SelectNodes() cita a recomendação XPath 1.0 do W3C, e as extensões de LINQ to XML descrevem a ordem dos seus resultados com base nessa mesma recomendação.
Tudo o que o XPath 2.0 e o 3.1 adicionaram simplesmente não existe. upper-case(), matches(), o operador except e as expressões if/then/else lançam uma XPathException. A mensagem para uma função inexistente culpa um gerenciador de namespaces, e não a versão, o que leva as pessoas a procurar um problema completamente diferente.
Essas expressões são parecidas com as usadas para navegar pelas pastas de um sistema operacional, o que torna o XPath familiar para quem está começando a trabalhar com ele. A maioria das expressões deste artigo é formada por essas peças:
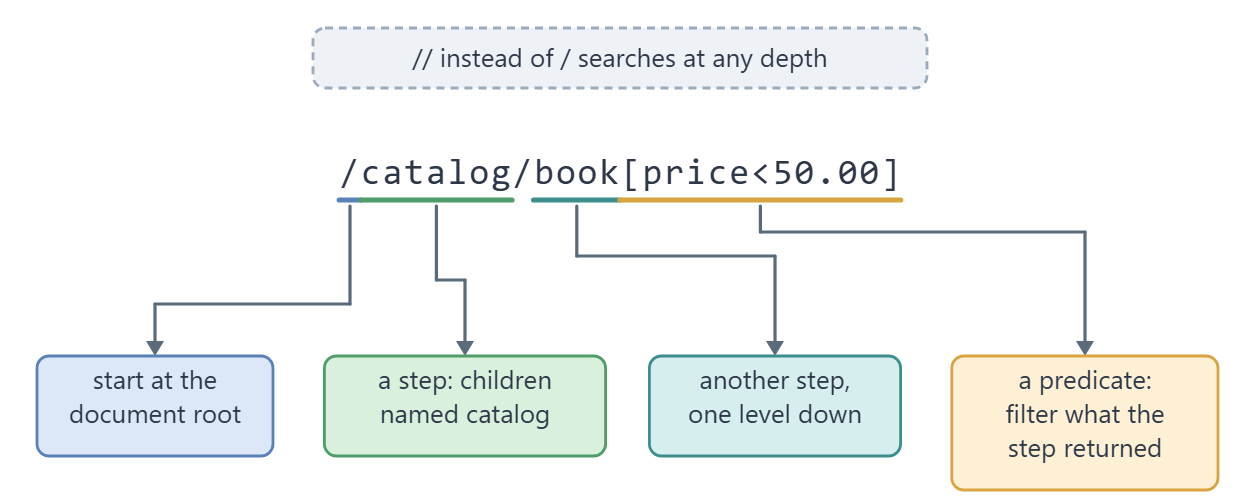
Veja o que algumas expressões encontram e quantos nós cada uma retorna no catálogo acima:
| Expressão de exemplo | O que ela encontra | No catálogo de exemplo |
|---|---|---|
/catalog | o elemento raiz catalog | 1 nó |
/catalog/book | cada filho book de catalog que não está em nenhum namespace | 3 dos 4 livros |
/catalog/book[1] | o primeiro filho book de catalog | 1 nó |
/catalog/book[last()] | o último desses book | 1 nó |
/catalog/book[@id='3'] | o book cujo atributo id é 3 | 1 nó |
/catalog/book[price<50.00] | cada um desses book com preço abaixo de 50,00 | 2 nós |
/catalog/book[price>10.00]/author | o author de cada um desses book com preço acima de 10,00 | 3 nós |
//book | cada book em qualquer profundidade, ainda sem namespace | 3 nós |
//book/@id | o atributo id de cada um deles | 3 nós |
//catalog/*[local-name()='book'] | cada filho book, seja qual for o namespace | os 4 livros |
Em resumo, as expressões XPath permitem combinar vários critérios para selecionar um nó ou um conjunto de nós. Os trechos entre colchetes são chamados de predicados.
Configuração do projeto
Para entender como o XPath funciona na prática, vamos criar um projeto para testar diferentes alternativas de navegação por um arquivo XML.
Como é um projeto de exemplo simples, vamos criar um projeto de console .NET simples. Se precisarmos gerar o documento em vez de ler um, o artigo sobre como criar arquivos XML em C# trata desse lado do trabalho.
Adição do arquivo XML ao projeto
Primeiro, vamos criar o arquivo XML adicionando um novo arquivo chamado BooksCatalog.xml em uma pasta Resources ao lado da pasta do projeto. Em seguida, vamos pegar o código anterior com os exemplos de livros e colá-lo nesse arquivo.
Depois de criá-lo, precisamos configurar o arquivo XML para ser copiado para a pasta de saída na compilação da aplicação. Em vez de fazer isso pelas propriedades do arquivo em uma IDE específica, vamos declarar essa configuração no arquivo de projeto, que funciona da mesma forma no Visual Studio, no Rider, no Visual Studio Code e na linha de comando:
<ItemGroup>
  <Content Include="..\Resources\BooksCatalog.xml" Link="BooksCatalog.xml">
    <CopyToOutputDirectory>Always</CopyToOutputDirectory>
  </Content>
</ItemGroup>
O valor Always substitui o arquivo XML na pasta de saída a cada compilação, o que garante que a aplicação sempre vai trabalhar com os dados mais recentes do catálogo.
E-book gratuito
Sua Web API está pronta para produção?
33 itens para verificar antes de implantá-la, com a correção de cada um. Um PDF gratuito de 76 páginas para .NET 10.
O e-book está em inglês.
Baixe o checklist gratuitoPDF gratuito. Um único e-mail para enviá-lo. Cancele a inscrição quando quiser.
Qual a diferença entre SelectSingleNode() e SelectNodes()?
SelectSingleNode() retorna o primeiro nó que corresponde a uma expressão, como um único XmlNode. SelectNodes() retorna todos eles, como uma XmlNodeList. Essa é a principal diferença de comportamento entre os dois.
Os dois são declarados em XmlNode, e não em XmlDocument, então podemos chamar qualquer um deles no documento, no elemento do documento ou em qualquer nó mais abaixo na árvore.
O nó em que os chamamos se torna o nó de contexto, o ponto de partida para uma expressão relativa. A partir do elemento catalog, book significa “os filhos book deste elemento”.
Uma expressão que começa com / ou // ignora o nó de contexto e começa pelo documento. Todas as expressões que o nosso código executa a partir do elemento raiz começam com //, então o root que passamos para os métodos não faz diferença em nenhum desses resultados.
Os dois métodos também têm uma sobrecarga que aceita um segundo argumento, um XmlNamespaceManager, necessário na seção depois desta.
| Método | Declarado em | Retorna | Quando nada corresponde |
|---|---|---|---|
SelectSingleNode() | XmlNode | XmlNode?, a primeira correspondência | null |
SelectNodes() | XmlNode | XmlNodeList?, todas as correspondências | uma lista vazia, Count 0 |
XPathSelectElement() | XNode, extensão | XElement?, a primeira correspondência | null |
XPathSelectElements() | XNode, extensão | IEnumerable<XElement>, todas as correspondências | uma sequência vazia, nunca null |
XPathEvaluate() | XNode, extensão | object: um double, string, bool ou uma sequência de nós | depende da expressão |
XPathNavigator.Select() | XPathNavigator | XPathNodeIterator | um iterador com Count 0 |
Antes de começar a ler dados específicos do arquivo, vejamos o que precisamos fazer para carregar o arquivo na memória:
using System.Xml;
using System.Xml.Linq;

var path = Path.Combine(AppContext.BaseDirectory, "BooksCatalog.xml");

var doc = new XmlDocument();
doc.Load(path);
var root = doc.DocumentElement!;
Criamos uma instância da classe XmlDocument para representar os dados na memória. Em seguida, passamos o caminho do arquivo como argumento para o método Load(), que carrega o documento especificado. Montamos esse caminho a partir de AppContext.BaseDirectory para que ele aponte para a cópia que fica ao lado do executável, e é isso que faz o exemplo rodar tanto com dotnet run quanto a partir de uma IDE.
Além disso, acessamos o elemento base pela propriedade DocumentElement e o atribuímos a uma nova variável, root. Essa propriedade é declarada como anulável, e o operador tolerante a null ! afirma algo que podemos provar aqui: um documento bem formado que acabou de ser carregado tem um elemento do documento. Na frente de SelectSingleNode(), como veremos, o mesmo operador estaria escondendo um valor que realmente pode ser null.
Agora estamos prontos para executar as consultas sobre os dados. Todo método daqui em diante fica dentro de uma classe estática, que declaramos em Program.cs, abaixo do código de carregamento. Então, vamos criar um método para fazer isso:
public static string? SelectSingleBook(XmlNode root)
{
    var node = root.SelectSingleNode("//catalog/book[position()=2]");

    return node is null ? null : FormatXml(node.OuterXml);
}
O método SelectSingleBook() recebe o elemento raiz como parâmetro e consulta o livro na segunda posição do catálogo. Ele retorna null quando a consulta não encontra nada, e é por isso que o tipo de retorno é string?. No entanto, a propriedade OuterXml, que contém todas as informações dentro do elemento selecionado, usa uma representação dos dados em uma única linha. Antes de colocar uma expressão como essa no código, você pode usar o XPath Tester para colar o seu XML, testar a expressão e ver exatamente quais nós ela encontra.
Para deixar o texto mais legível, como vemos no arquivo de exemplo, precisamos criar um método formatador:
public static string FormatXml(string unformattedXml)
{
    return XElement.Parse(unformattedXml).ToString();
}
Em seguida, a string retornada pelo método FormatXml() é exibida no console com todas as informações do elemento:
Selected book:
<book id="2">
  <author>Assis, Machado De</author>
  <title>Dom Casmurro</title>
  <genre>Romance</genre>
  <price>50.00</price>
</book>
Na sequência, vamos criar outro método para selecionar um grupo de itens:
public static List<string> SelectBooks(XmlNode root)
{
    var nodes = root.SelectNodes("//catalog/book[price<50.00]");

    if (nodes is null)
    {
        return [];
    }

    return nodes
        .Cast<XmlNode>()
        .Select(x => FormatXml(x.OuterXml))
        .ToList();
}
Da mesma forma, o método SelectBooks() recebe o elemento raiz como parâmetro. Mas, desta vez, consultamos todos os elementos com price menor que 50,00.
Depois de obter o resultado da consulta (um objeto XmlNodeList), convertemos esse resultado em uma lista de strings que contém o OuterXml formatado de cada elemento. O compilador considera que SelectNodes() retorna uma lista anulável, então, nesse caso, retornamos uma lista vazia em vez de silenciar o aviso com !.
Por fim, o resultado é retornado e impresso no console:
Selected books:
<book id="1">
  <author>King, Stephen</author>
  <title>IT</title>
  <genre>Horror</genre>
  <price>40.00</price>
</book>
<book id="3">
  <author>Calaprice, Alice; Lipscombe, Trevor</author>
  <title>Albert Einstein: A Biography</title>
  <genre>Biography</genre>
  <price>30.00</price>
</book>
Como consultar XML que usa namespaces?
Em outra situação, lidamos com modelos XML que contêm namespaces. A ideia dos namespaces é permitir que as aplicações tratem ou validem elementos de forma diferente, mesmo que eles tenham o mesmo nome.
Felizmente, a linguagem XPath também oferece suporte a namespaces na string do caminho. Como mostra o exemplo, o último livro do catálogo tem um atributo a mais que indica um namespace:
<book id="4" xmlns="urn:example-schema">
A referência da Microsoft para XmlNode.SelectNodes() enuncia a regra que decide o que uma expressão sem prefixo encontra: “Se a expressão XPath não incluir um prefixo, presume-se que o URI do namespace é o namespace vazio.” É por isso que //book retorna três dos nossos quatro livros e deixa de fora o que declara um namespace padrão.
Agora, vamos criar o método de seleção para consultar o livro que contém o namespace:
public static List<string> SelectBooksUsingNamespaces(XmlDocument doc)
{
    var nsmgr = new XmlNamespaceManager(doc.NameTable);
    nsmgr.AddNamespace("ex", "urn:example-schema");

    var nodes = doc.SelectNodes("descendant::ex:book", nsmgr);

    if (nodes is null)
    {
        return [];
    }

    return nodes
        .Cast<XmlNode>()
        .Select(x => FormatXml(x.OuterXml))
        .ToList();
}
Como podemos ver, o método SelectBooksUsingNamespaces() recebe um XmlDocument como parâmetro, enquanto os outros dois recebem um XmlNode. É uma questão de conveniência: XmlNamespaceManager precisa de um XmlNameTable, e a propriedade NameTable fica em XmlDocument, que um nó alcança por meio de OwnerDocument. Em seguida, na parte inicial da função, criamos uma instância de XmlNamespaceManager usando os dados fornecidos pela variável do argumento.
E-book gratuito
Sua Web API está pronta para produção?
33 itens para verificar antes de implantá-la, com a correção de cada um. Um PDF gratuito de 76 páginas para .NET 10.
O e-book está em inglês.
Baixe o checklist gratuitoPDF gratuito. Um único e-mail para enviá-lo. Cancele a inscrição quando quiser.
Depois, o método AddNamespace() cria uma associação com o namespace esperado. Em seguida, executamos o método SelectNodes(), mas agora usando a variável nsmgr além da expressão de consulta.
Por fim, convertemos o resultado antes de retorná-lo. Assim, o resultado do método é impresso no console:
Selected books:
<book id="4" xmlns="urn:example-schema">
  <author>Fowler, Martin; Beck, Kent</author>
  <title>Refactoring: Improving the design of existing code</title>
  <genre>Scientific</genre>
  <price>60.00</price>
</book>
O que acontece quando uma consulta XPath não encontra nada?
Os dois métodos respondem a isso de forma diferente, e é nessa diferença que podem começar as exceções NullReferenceException em código que lida com XML.
SelectSingleNode() retorna null. Não existe um nó vazio para retornar, então quem chama o método precisa verificar o resultado antes de acessar OuterXml ou InnerText.
SelectNodes(), por sua vez, retorna uma XmlNodeList vazia. Executar //catalog/book[price>1000] no nosso catálogo retorna uma lista com Count igual a 0, então um foreach sobre ela não faz nada e nenhuma exceção é lançada. Não encontrar correspondência é um resultado comum para os dois métodos, nunca um erro, então nenhum deles lança exceção ao retornar.
Os dois métodos são declarados com tipos de retorno anuláveis, XmlNode? e XmlNodeList?, e é por isso que, com os tipos de referência anuláveis ativados, o compilador espera verificações de null ou o operador tolerante a null !.
Vale a pena ser honesto sobre esse operador. Ele silencia o compilador, mas não faz um valor deixar de ser null. Na frente de SelectSingleNode(), ele esconde uma falha real, então uma verificação de null se justifica ali.
Uma consulta que não encontra nada não é um erro, então a verificação deve ficar no nosso código, e não em um bloco try:
var node = root.SelectSingleNode("//catalog/book[price>1000]");

if (node is null)
{
    Console.WriteLine("No book matched the query.");
    return;
}

Console.WriteLine(FormatXml(node.OuterXml));
Observe que nada aqui captura uma exceção. SelectSingleNode() retorna null em vez de lançar uma exceção, e o if é todo o tratamento necessário.
Como executar XPath sobre um XDocument?
XDocument é o tipo de documento do LINQ to XML, e o XPath chega até ele por meio de métodos de extensão, e não de métodos de instância. Eles ficam no namespace System.Xml.XPath, então a diretiva using precisa estar presente, senão os métodos nunca aparecem no tipo.
XPathSelectElement() retorna o primeiro XElement correspondente, ou null. XPathSelectElements() retorna um IEnumerable<XElement> vazio, nunca null, quando nada corresponde. XPathEvaluate() cobre expressões que não retornam nós, então count(//book) volta como um double.
As expressões são o mesmo XPath 1.0, e a regra de namespaces também é a mesma. Uma sobrecarga de cada método recebe um IXmlNamespaceResolver, e XmlNamespaceManager implementa essa interface, então um único gerenciador de namespaces atende às duas APIs. Os elementos voltam na ordem do documento, uma garantia que os métodos de extensão dão e que a recomendação em si não dá.
Use esses métodos quando o código ao redor já usa LINQ to XML e uma consulta específica fica mais legível como caminho do que como uma cadeia de chamadas a Elements().
Se o objetivo é ler um documento, e não consultá-lo, o artigo sobre como ler documentos XML em C# trata do carregamento, e o artigo sobre LINQ to XML trata da sintaxe de consulta ao lado da qual esses métodos de extensão ficam.
O mesmo predicado que usamos com SelectNodes(), desta vez aplicado a um XDocument:
public static List<string> SelectBooksWithLinqToXml(XDocument doc)
{
    return doc
        .XPathSelectElements("//catalog/book[price<50.00]")
        .Select(x => x.ToString())
        .ToList();
}
Observe que não há nenhum ! em lugar nenhum: XPathSelectElements() retorna uma sequência não anulável, então o compilador não tem do que reclamar.
A saída no console, produzida ao executar o projeto:
Selected books with LINQ to XML:
<book id="1">
  <author>King, Stephen</author>
  <title>IT</title>
  <genre>Horror</genre>
  <price>40.00</price>
</book>
<book id="3">
  <author>Calaprice, Alice; Lipscombe, Trevor</author>
  <title>Albert Einstein: A Biography</title>
  <genre>Biography</genre>
  <price>30.00</price>
</book>
Conclusão
O XPath nos dá uma única string que descreve exatamente os nós que queremos, e o .NET nos entrega esse recurso por meio de SelectSingleNode(), para a primeira correspondência, e de SelectNodes(), para todas elas, ou por meio de XPathSelectElement() e XPathSelectElements() quando já estamos trabalhando com um XDocument.
Duas coisas costumam pegar as pessoas de surpresa, e vale a pena lembrar das duas: o .NET só fala XPath 1.0, e um nome sem prefixo em uma expressão significa “em nenhum namespace”, então um documento com namespace padrão precisa de um XmlNamespaceManager e de um prefixo, ou de um teste com local-name(). Quando percorrer os nós à mão dá mais trabalho do que compensa, desserializar o documento inteiro em objetos é a outra forma de ler um documento.
Testado com .NET 10.0.10.