Para comparar duas listas por uma única propriedade, coloque a chave usada na correspondência em um HashSet e depois filtre a outra lista com base nele. São duas linhas e, no nosso benchmark com 10.000 clientes e 500.000 pedidos, essa abordagem supera todas as alternativas por ampla margem.
O motivo é o custo de cada abordagem por elemento. Um loop aninhado ou um Where com um Any interno percorre a segunda lista de novo para cada item da primeira; um HashSet consulta cada chave uma única vez, em tempo constante.
Como comparar duas listas em C#?
Depende de qual destas três perguntas estamos realmente fazendo, e elas têm respostas diferentes.
A primeira é a interseção: quais itens aparecem nas duas listas. Monte um HashSet com a chave de uma lista e depois filtre a outra com Contains: buscas em tempo constante em vez de uma varredura por elemento.
A segunda é a diferença: quais itens estão em uma lista e não na outra. Para isso existe o ExceptBy, que recebe as chaves a excluir e o seletor de chave, mantém um item por chave e responde em um sentido de cada vez. Execute-o nos dois sentidos para obter a diferença completa.
A terceira é a igualdade: se as duas listas contêm as mesmas coisas. SequenceEqual compara elemento por elemento, em ordem; SetEquals em um HashSet ignora a ordem e as duplicatas.
A maior parte do que vem a seguir responde à primeira pergunta, que é a mais comum, e compara cinco formas de fazer isso.
Criação da aplicação de comparação
Para começar, vamos criar uma nova aplicação de console com o comando dotnet new console -n App na janela de comandos. No nosso exemplo, temos uma classe Customer com uma propriedade Id de valor único e uma classe Order com uma propriedade CustomerId que relaciona uma entidade à outra.
Vamos criar a primeira classe, referente a Customer:
public class Customer
{
    public int Id { get; set; }
    public string Firstname { get; set; }
    public string Surname { get; set; }
}
E agora vamos implementar uma classe Order simples:
public class Order
{
    public int CustomerId { get; set; }
    public int OrderId { get; set; }
}
Antes de testar os métodos, vamos preencher duas listas com registros de exemplo:
var customers = new List<Customer>()
{
    new() { Id = 1, Firstname = "Alice", Surname = "Smith"},
    new() { Id = 2, Firstname = "John", Surname = "Terry"},
    new() { Id = 3, Firstname = "Fred", Surname = "Staton"}
};

var orders = new List<Order>()
{
    new () {CustomerId = 1, OrderId = 101},
    new () {CustomerId = 2, OrderId = 102},
    new () {CustomerId = 2, OrderId = 103}
};
Inicializamos uma List de Customer e uma List de Order, cada uma com três instâncias. A propriedade CustomerId da classe Order se liga à propriedade Id do cliente correspondente na lista Customer, formando uma relação entre os clientes e os pedidos deles. O objetivo é obter uma lista de clientes distintos que fizeram pedidos.
Todos os métodos aqui recebem e retornam uma List, mas nada nas técnicas depende disso. Se não tivermos certeza de qual abstração usar na declaração dos parâmetros, ajuda saber como IEnumerable, ICollection e IList se relacionam.
Uso de loops foreach para comparar duas listas
Vamos começar implementando um método que usa dois loops foreach, dentro de public static class ListCompareMethods, em um novo arquivo que vai reunir todos os nossos métodos de comparação:
public static List<Customer> ForEachMethod(List<Customer> customerList, List<Order> orderList)
{
    var customersWithOrders = new List<Customer>();

    foreach (var customer in customerList)
    {
        foreach (var order in orderList)
        {
            if (customer.Id == order.CustomerId && !customersWithOrders.Contains(customer))
            {
                customersWithOrders.Add(customer);
            }
        }
    }

    return customersWithOrders;
}
Cada método que implementamos recebe dois parâmetros de lista, List<Customer> e List<Order>, respectivamente. O resultado é sempre uma List<Customer> com os registros dos clientes que fizeram pedidos.
Primeiro, inicializamos uma List<Customer> vazia, customersWithOrders, para guardar os clientes que identificarmos. Depois, com loops foreach aninhados, iteramos por cada cliente de customerList e por cada pedido de orderList. Para cada par cliente-pedido, verificamos se o Id do cliente corresponde ao CustomerId do pedido e se o cliente ainda não está na lista customersWithOrders.
Quando essas condições são atendidas, adicionamos o cliente à lista customersWithOrders. Repetimos o processo até examinar todas as combinações e, então, retornamos a lista customersWithOrders. Embora essa abordagem cumpra o objetivo, a complexidade de tempo dela é O(n×m), em que ‘n’ é o número de clientes e ‘m’ o número de pedidos. E a verificação com Contains() acrescenta uma terceira varredura, sobre a lista de resultados, a cada correspondência.
Por fim, para verificar o resultado, vamos exibir a lista resultante:
var customerWithOrders = ListCompareMethods.ForEachMethod(customers, orders);
Console.WriteLine(string.Join(',',customerWithOrders.Select(i=>i.Firstname)));
Imprimimos no console os objetos da lista customerWithOrders. Em seguida, para concatenar os valores de Firstname em uma única string separada por vírgulas, usamos string.Join(). Isso é feito com o método Select(), que projeta cada objeto Customer no seu Firstname:
Alice,John
E-book gratuito
Sua Web API está pronta para produção?
33 itens para verificar antes de implantá-la, com a correção de cada um. Um PDF gratuito de 76 páginas para .NET 10.
O e-book está em inglês.
Baixe o checklist gratuitoPDF gratuito. Um único e-mail para enviá-lo. Cancele a inscrição quando quiser.
Confirmamos que esses dois objetos eram o resultado esperado, já que a lista Order inclui Customer com Id 1 e 2.
LINQ e a extensão Where
Neste método, vamos usar o LINQ e a extensão Where():
public static List<Customer> WhereAnyMethod(List<Customer> customerList, List<Order> orderList)
{
    return customerList.Where(y => orderList.Any(z => z.CustomerId == y.Id)).ToList();
}
Aqui, usamos o LINQ para filtrar customerList com base em uma condição específica. Para cada Customer em customerList, verificamos se existe algum Order em orderList em que o CustomerId do Order corresponda ao Id do Customer.
Se esse Order existir, incluímos o Customer no resultado. Antes de retorná-lo, convertemos o resultado filtrado para o tipo List<Customer>. A filtragem é um trabalho comum para o método Where; o que nos custa caro aqui é o Any() interno, que percorre orderList de novo para cada cliente.
Comparação de listas com a sintaxe de consulta do LINQ
Agora, vamos escrever o mesmo filtro na sintaxe de consulta do LINQ:
public static List<Customer> JoinMethod(List<Customer> customerList, List<Order> orderList)
{
    var customersWithOrders = (from customer in customerList
                               where orderList.Any(order => customer.Id == order.CustomerId)
                               select customer
                               ).ToList();

    return customersWithOrders;
}
Esta é a versão em sintaxe de consulta do método anterior, e não um algoritmo diferente. As cláusulas from … where … select são compiladas para a mesma chamada a Where(), com o mesmo Any() interno, e é por isso que os dois ficam praticamente empatados no benchmark mais adiante.
Aqui, usamos o LINQ para iterar por cada elemento de customerList com a cláusula from. Depois, usamos a cláusula where para filtrar os clientes pela existência de algum Order em orderList cujo CustomerId corresponda ao Id do Customer atual.
Em seguida, a cláusula select determina o que entra no resultado, selecionando o objeto Customer que satisfaz a condição do filtro. Por fim, colocamos toda a consulta LINQ entre parênteses e chamamos o método ToList() para converter o resultado em uma List<Customer> materializada.
Comparação de listas com o método de extensão Join
Vamos usar o método de extensão Join() do LINQ para encontrar os clientes com pedidos:
public static List<Customer> JoinListMethod(List<Customer> customerList, List<Order> orderList)
{
    return customerList.Join(
            orderList,
            customer => customer.Id,
            order => order.CustomerId,
            (customer, order) => customer
        ).Distinct().ToList();
}
Aqui, fazemos uma operação de inner join entre duas listas, customerList e orderList. O método usa o LINQ para unir as listas com base em chaves correspondentes: a propriedade Id de cada Customer em customerList e a propriedade CustomerId de cada Order em orderList. O resultado do join é uma sequência de elementos emparelhados, em que cada par é formado por um Customer e o Order correspondente.
O seletor de resultado (customer, order) => customer especifica que apenas a parte Customer de cada par entra no resultado final. Depois, usamos o método Distinct() para garantir que cada Customer apareça só uma vez no resultado, removendo as duplicatas.
Por fim, convertemos o resultado em uma List<Customer> com o método ToList().
Uso de HashSet para comparar as listas
A próxima solução usa a estrutura de dados HashSet para obter o resultado que queremos:
public static List<Customer> HashSetMethod(List<Customer> customerList, List<Order> orderList)
{
    var customerIds = orderList.Select(i => i.CustomerId).ToHashSet();

    return customerList.Where(i => customerIds.Contains(i.Id)).ToList();
}
Desta vez, criamos uma coleção HashSet, customerIds, com os valores únicos de CustomerId que extraímos de orderList. O HashSet garante que incluamos apenas valores distintos e torna eficientes as verificações de pertencimento.
Em seguida, o método filtra customerList com o método Where(). Ele inclui no resultado apenas os clientes cujo Id está presente no HashSet customerIds. Por fim, convertemos o resultado em uma List<Customer> com o método ToList().
Como encontrar a diferença entre duas listas?
Com ExceptBy, que a referência do LINQ da Microsoft define como o método que produz “a diferença de conjuntos de duas sequências de acordo com uma função seletora de chave especificada”.
A diferença em relação a Except importa aqui. Except compara elementos inteiros, então dois objetos Customer com o mesmo Id continuam diferentes, a menos que o tipo sobrescreva (override) a igualdade. ExceptBy recebe as chaves a excluir e um seletor para a nossa própria chave, então compara por Id e ignora o resto do objeto.
Ele responde em um sentido de cada vez. customers.ExceptBy(orderedIds, c => c.Id) nos dá os clientes sem pedidos; invertendo os argumentos, obtemos os pedidos sem cliente correspondente, um por CustomerId, já que ExceptBy mantém apenas o primeiro elemento de cada chave. Uma diferença completa, nos dois sentidos, significa executá-lo duas vezes e guardar os dois resultados.
O argumento de desempenho é o mesmo de antes: ExceptBy monta internamente um conjunto com as chaves, então faz uma única passada por cada lista, em vez de uma varredura por elemento.
ExceptBy está disponível em System.Linq desde o .NET 6, incluindo o .NET 10, então não precisa de pacote nem de método auxiliar:
var orderedIds = orders.Select(o => o.CustomerId);

var customersWithoutOrders = customers.ExceptBy(orderedIds, c => c.Id).ToList();
Se precisarmos comparar objetos inteiros em vez de uma chave, o artigo sobre o método Except no LINQ trata desse caso em detalhes. E, quando tudo o que queremos é uma resposta de sim ou não, em vez de uma lista, verificar se os itens de uma lista existem em outra é um trabalho menor.
E-book gratuito
Sua Web API está pronta para produção?
33 itens para verificar antes de implantá-la, com a correção de cada um. Um PDF gratuito de 76 páginas para .NET 10.
O e-book está em inglês.
Baixe o checklist gratuitoPDF gratuito. Um único e-mail para enviá-lo. Cancele a inscrição quando quiser.
Agora, vamos comparar os nossos cinco métodos de interseção executando um conjunto de benchmarks.
Configuração do benchmark
Seguimos avaliando esses métodos com um benchmark, em termos de eficiência e velocidade. Vamos adicionar o pacote BenchmarkDotNet com dotnet add package BenchmarkDotNet, começar o arquivo da classe de benchmark com using BenchmarkDotNet.Attributes; e configurar nessa classe dois métodos auxiliares para testar o desempenho da comparação de listas:
private List<Customer>? _customers;
private List<Order>? _orders;

[GlobalSetup]
public void GlobalSetup()
{
    var numberOfCustomers = 10000;
    var numberOfOrders = 500000;

    _customers = GenerateRandomCustomers(numberOfCustomers).ToList();
    _orders = GenerateRandomOrders(numberOfOrders, _customers).ToList();
}

private static IEnumerable<Customer> GenerateRandomCustomers(int count)
{
    return Enumerable.Range(1, count)
        .Select(i => new Customer
        {
            Id = i,
            Firstname = $"CustomerFirstname{i}",
            Surname = $"CustomerSurname{i}"
        });
}

private static IEnumerable<Order> GenerateRandomOrders(int count, List<Customer> customers)
{
    var random = new Random();

    return Enumerable.Range(1, count)
        .Select(i => new Order
        {
            OrderId = i,
            CustomerId = random.Next(1, customers.Count + 1)
        });
}
Na nossa classe de benchmark, o método GlobalSetup() prepara os dados de que precisamos para as avaliações de desempenho. Nós o marcamos com o atributo [GlobalSetup] para que ele seja executado uma vez antes de cada método de benchmark.
Dentro dele, inicializamos _customers e _orders com conjuntos de dados realistas e aleatórios. Mais especificamente, usamos o método GenerateRandomCustomers() para criar uma lista de 10.000 clientes, cada um com ID, nome e sobrenome únicos. Em seguida, preenchemos a lista _orders com o método GenerateRandomOrders(), gerando 500.000 pedidos com OrderIds únicos e associando cada pedido a um cliente selecionado aleatoriamente da lista _customers.
O método GenerateRandomCustomers() se encarrega de criar uma sequência de objetos Customer com base na quantidade especificada. Usando Enumerable.Range() para produzir uma sequência de inteiros, empregamos o método Select() para gerar um novo objeto Customer para cada inteiro, o que garante Ids distintos.
Da mesma forma, o método GenerateRandomOrders() gera uma sequência de objetos Order aleatórios, considerando a quantidade desejada e a lista de clientes. Com Enumerable.Range() e o método Select(), criamos objetos Order e definimos a propriedade CustomerId de cada pedido como um valor selecionado aleatoriamente entre 1 e o total de clientes. Com isso, estabelecemos uma associação válida entre pedidos e clientes.
Juntos, esses métodos auxiliares nos permitem montar um conjunto de dados realista para o benchmark dos métodos criados para comparar e filtrar listas de clientes e pedidos com base em uma propriedade específica.
Resultados da avaliação
Vamos avaliar os resultados do benchmark:
| Method         | Mean         | Error        | StdDev     | Rank | Gen0      | Allocated   |
|--------------- |-------------:|-------------:|-----------:|-----:|----------:|------------:|
| HashSetMethod  |     16.02 ms |     3.303 ms |   0.858 ms |    1 |         - |   732.91 KB |
| JoinListMethod |     52.06 ms |    55.950 ms |  14.530 ms |    2 | 1000.0000 | 13302.52 KB |
| JoinMethod     |     80.63 ms |     7.172 ms |   1.862 ms |    3 |         - |   440.88 KB |
| WhereAnyMethod |     84.47 ms |    11.028 ms |   2.864 ms |    4 |         - |   440.93 KB |
| ForEachMethod  | 24,058.62 ms | 3,555.263 ms | 923.291 ms |    5 |         - |   256.41 KB |
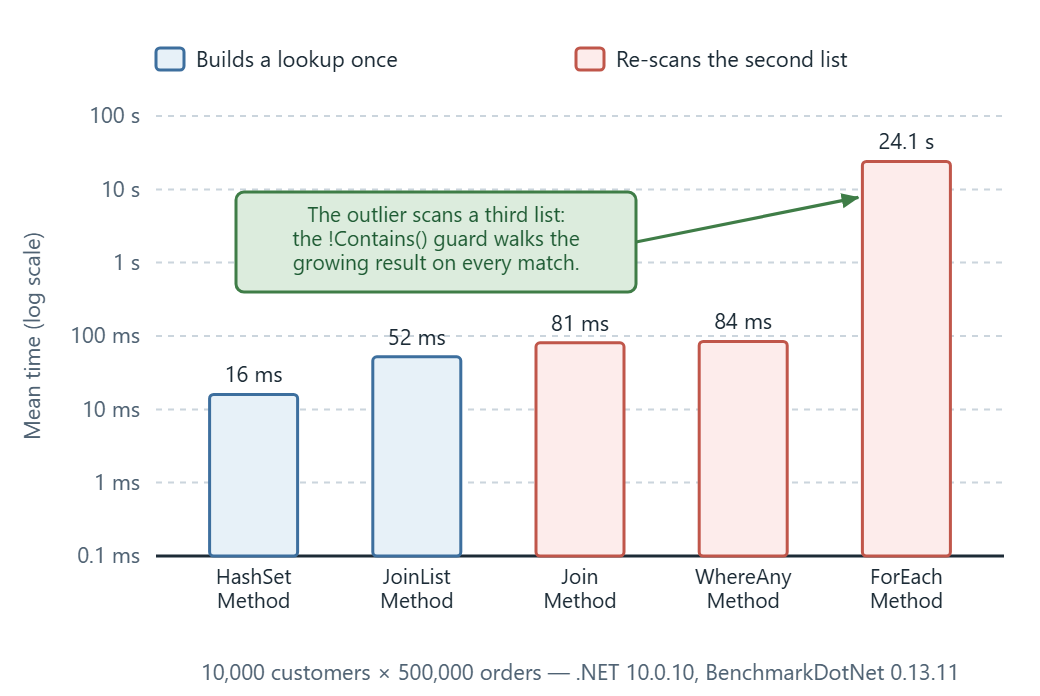
HashSetMethod() é o mais rápido, com 16 ms, e é o mais rápido por um motivo estrutural, e não por uma micro-otimização: ele projeta as chaves dos pedidos em um HashSet uma única vez e depois responde a cada pergunta de pertencimento em tempo constante. O custo dele acompanha a soma dos tamanhos das duas listas, e não o produto deles. JoinListMethod() fica em segundo, com 52 ms, e funciona da mesma forma, porque Join() monta uma estrutura de busca (lookup) sobre a sequência interna antes de começar a fazer as correspondências. Ele paga pela estrutura de busca que monta sobre todos os 500.000 pedidos, e é daí que vêm os 13 MB de alocações dele.
JoinMethod(), com 80,63 ms, e WhereAnyMethod(), com 84,47 ms, ficam a menos de 5% um do outro, e isso não é coincidência: são o mesmo filtro Where mais Any, escrito na sintaxe de consulta e na sintaxe de método, então os dois percorrem orderList de novo para cada cliente. ForEachMethod() é cerca de 285 vezes mais lento ainda, com pouco mais de 24 segundos, porque o loop interno dele nunca para na primeira correspondência, então lê todos os 500.000 pedidos para cada cliente e, além disso, a verificação com !customersWithOrders.Contains(customer) percorre a lista de resultados, que só cresce, a cada correspondência. Medido no .NET 10.0.10 com o BenchmarkDotNet 0.13.11, em uma execução de monitoramento de cinco iterações.
Qual método usar para comparar duas listas?
Use a abordagem com HashSet. No benchmark acima, ela termina em 16 milissegundos, enquanto o foreach aninhado leva 24 segundos: o mesmo trabalho, com três ordens de grandeza de diferença.
A classificação não é, na verdade, sobre cinco técnicas, e sim sobre dois algoritmos. HashSetMethod e JoinListMethod montam uma estrutura de busca uma vez e a consultam, o que os coloca nos dois primeiros lugares. WhereAnyMethod e JoinMethod percorrem a segunda lista de novo para cada elemento da primeira, e é por isso que estão a menos de 5% um do outro e ficam cada vez mais para trás à medida que as listas crescem.
ForEachMethod é um caso à parte, e não um terceiro membro desse grupo. Ele lê todos os pedidos para cada cliente em vez de parar na primeira correspondência, e a verificação de duplicatas dele também percorre a lista de resultados. Ele leva cerca de 285 vezes mais tempo que o penúltimo colocado.
Vale a pena conhecer Join por outro motivo. Ele retorna pares, então, quando precisamos do pedido correspondente junto com o cliente, é o único dos quatro métodos LINQ que nos dá os dois.
| O que precisamos | O que usar | Formato |
|---|---|---|
| Itens de A que também existem em B, comparados por uma chave | HashSet com as chaves de B e depois Where | var keys = b.Select(x => x.Key).ToHashSet(); |
| Itens de A que não existem em B | ExceptBy | a.ExceptBy(b.Select(x => x.Key), x => x.Key) |
| Itens de B que não existem em A | ExceptBy, com os argumentos invertidos | Cada chamada mantém um item por chave; execute nos dois sentidos para obter a diferença completa |
| As duas listas emparelhadas pela chave | Join | Retorna os pares, e não só um dos lados |
| Se as duas listas têm os mesmos itens, na mesma ordem | SequenceEqual | Igualdade elemento a elemento, considerando a ordem |
| Se as duas listas têm os mesmos itens, em qualquer ordem | HashSet.SetEquals | Ignora a ordem e as duplicatas |
| Listas pequenas, comparando objetos inteiros | Qualquer uma das opções acima | Com menos de algumas centenas de itens, a diferença fica bem abaixo de um milissegundo |
Conclusão
São cinco formas de comparar duas listas por uma única propriedade, e o benchmark as separa em dois algoritmos, e não em cinco técnicas: montar uma estrutura de busca uma vez ou percorrer a segunda lista de novo para cada elemento. A abordagem com HashSet é a que devemos usar, Join() quando precisamos dos dois lados da correspondência e ExceptBy quando a pergunta é a diferença, e não a interseção.
O mesmo raciocínio baseado em chaves se aplica diretamente à comparação de dois dicionários, em que a estrutura de busca já vem pronta.
Testado com .NET 10.0.10.