Para comparar dos listas por una sola propiedad, guarda en un HashSet la clave por la que buscas coincidencias y después filtra la otra lista con él. Son dos líneas, y en nuestro benchmark de 10 000 clientes y 500 000 pedidos supera a todas las alternativas por un amplio margen.
La razón está en lo que cuesta cada enfoque por elemento. Un bucle anidado o un Where con un Any interno vuelve a recorrer la segunda lista para cada elemento de la primera; un HashSet busca cada clave una sola vez, en tiempo constante.
¿Cómo comparar dos listas en C#?
Depende de cuál de estas tres preguntas nos estemos haciendo en realidad, y cada una tiene una respuesta distinta.
La primera es la de las coincidencias: qué elementos aparecen en las dos listas. Construye un HashSet con la clave de una lista y después filtra la otra con Contains: búsquedas en tiempo constante en lugar de un recorrido por elemento.
La segunda es la diferencia: qué elementos están en una lista y no en la otra. Para eso está ExceptBy, que recibe las claves que hay que excluir y el selector de clave, conserva un elemento por clave y solo responde en un sentido cada vez. Ejecútalo en los dos sentidos para obtener la diferencia completa.
La tercera es la igualdad: si las dos listas contienen lo mismo. SequenceEqual compara elemento a elemento y en orden; SetEquals sobre un HashSet ignora el orden y los duplicados.
Casi todo lo que viene a continuación resuelve la primera pregunta, que es la habitual, y compara cinco formas de hacerlo.
Crear la aplicación de comparación
Para empezar, creemos una nueva aplicación de consola con el comando dotnet new console -n App en la ventana de comandos. En nuestro ejemplo, tenemos una clase Customer con una propiedad Id única y una clase Order con una propiedad CustomerId que relaciona una entidad con la otra.
Creemos la primera clase, la correspondiente a Customer:
public class Customer
{
    public int Id { get; set; }
    public string Firstname { get; set; }
    public string Surname { get; set; }
}
Y ahora implementemos una clase Order sencilla:
public class Order
{
    public int CustomerId { get; set; }
    public int OrderId { get; set; }
}
Antes de probar los métodos, rellenemos dos listas con datos de ejemplo:
var customers = new List<Customer>()
{
    new() { Id = 1, Firstname = "Alice", Surname = "Smith"},
    new() { Id = 2, Firstname = "John", Surname = "Terry"},
    new() { Id = 3, Firstname = "Fred", Surname = "Staton"}
};

var orders = new List<Order>()
{
    new () {CustomerId = 1, OrderId = 101},
    new () {CustomerId = 2, OrderId = 102},
    new () {CustomerId = 2, OrderId = 103}
};
Inicializamos una List de objetos Customer y una List de objetos Order, cada una con tres instancias. La propiedad CustomerId de la clase Order enlaza con la propiedad Id del cliente que le corresponde en la lista Customer, lo que crea una relación entre los clientes y sus pedidos. El objetivo es obtener una lista de clientes sin duplicados que hayan hecho pedidos.
Todos los métodos de este artículo reciben y devuelven una List, pero nada en las técnicas depende de eso. Si no tenemos claro con qué abstracción declarar los parámetros, conviene saber qué relación hay entre IEnumerable, ICollection y IList.
Usar bucles foreach para comparar dos listas
Empecemos por implementar un método que usa dos bucles foreach, dentro de public static class ListCompareMethods, en un archivo nuevo que contendrá todos nuestros métodos de comparación:
public static List<Customer> ForEachMethod(List<Customer> customerList, List<Order> orderList)
{
    var customersWithOrders = new List<Customer>();

    foreach (var customer in customerList)
    {
        foreach (var order in orderList)
        {
            if (customer.Id == order.CustomerId && !customersWithOrders.Contains(customer))
            {
                customersWithOrders.Add(customer);
            }
        }
    }

    return customersWithOrders;
}
Todos los métodos que implementamos reciben dos parámetros de lista, List<Customer> y List<Order>, respectivamente. El resultado es siempre una List<Customer> con los registros de los clientes que han hecho pedidos.
En primer lugar, inicializamos una List<Customer> vacía, customersWithOrders, para guardar los clientes que identificamos. Después, con bucles foreach anidados, recorremos cada cliente de customerList y cada pedido de orderList. Para cada par cliente-pedido, comprobamos si el Id del cliente coincide con el CustomerId del pedido y si el cliente no está ya en la lista customersWithOrders.
Cuando se cumplen estas condiciones, añadimos el cliente a la lista customersWithOrders. Repetimos el proceso hasta examinar todas las combinaciones y después devolvemos la lista customersWithOrders. Aunque este enfoque cumple nuestro objetivo, su complejidad temporal es O(n×m), donde ‘n’ es el número de clientes y ‘m’ el número de pedidos, y la comprobación con Contains() añade un tercer recorrido, sobre la lista de resultados, en cada coincidencia.
Por último, para comprobar el resultado, mostremos la lista resultante:
var customerWithOrders = ListCompareMethods.ForEachMethod(customers, orders);
Console.WriteLine(string.Join(',',customerWithOrders.Select(i=>i.Firstname)));
Imprimimos en la consola los objetos de la lista customerWithOrders. Para concatenar los valores de Firstname en una sola cadena separada por comas, usamos string.Join(). La proyección se hace con el método Select(), que convierte cada objeto Customer en su Firstname:
Alice,John
Ebook gratis
¿Tu Web API está lista para producción?
33 puntos que comprobar antes de desplegarla, con la solución de cada uno. Un PDF gratuito de 76 páginas para .NET 10.
El ebook está en inglés.
Descarga la checklist gratisPDF gratuito. Un solo correo para enviártelo. Puedes darte de baja cuando quieras.
Comprobamos que estos dos objetos son el resultado esperado, ya que la lista Order incluye Customer con Id 1 y 2.
LINQ y la extensión Where
En este método, vamos a usar LINQ y la extensión Where():
public static List<Customer> WhereAnyMethod(List<Customer> customerList, List<Order> orderList)
{
    return customerList.Where(y => orderList.Any(z => z.CustomerId == y.Id)).ToList();
}
Aquí usamos LINQ para filtrar customerList según una condición concreta. Para cada Customer de customerList, comprobamos si existe algún Order en orderList en el que el CustomerId de Order coincida con el Id de Customer.
Si existe ese Order, incluimos Customer en el resultado. Antes de devolverlo, convertimos el resultado filtrado en el tipo List<Customer>. El filtrado es trabajo normal para el método Where; lo que nos cuesta aquí es el Any() interno, que vuelve a recorrer orderList para cada cliente.
Comparar listas con la sintaxis de consulta de LINQ
Escribamos ahora el mismo filtro con la sintaxis de consulta de LINQ:
public static List<Customer> JoinMethod(List<Customer> customerList, List<Order> orderList)
{
    var customersWithOrders = (from customer in customerList
                               where orderList.Any(order => customer.Id == order.CustomerId)
                               select customer
                               ).ToList();

    return customersWithOrders;
}
Es la versión en sintaxis de consulta del método anterior, no un algoritmo distinto. Las cláusulas from … where … select se compilan en la misma llamada a Where() con el mismo Any() interno, y por eso los dos obtienen resultados muy parecidos en el benchmark de más abajo.
Aquí, usamos LINQ para recorrer cada elemento de customerList con la cláusula from. Después, usamos la cláusula where para filtrar los clientes en función de si existe algún Order en orderList cuyo CustomerId coincida con el Id del Customer actual.
La cláusula select determina entonces qué se incluye en el resultado y selecciona el objeto Customer que cumple la condición de filtrado. Por último, encerramos toda la consulta LINQ entre paréntesis y llamamos al método ToList() para convertir el resultado en una List<Customer> materializada.
Comparar listas con el método de extensión Join
Usemos el método de extensión Join() de LINQ para encontrar los clientes con pedidos:
public static List<Customer> JoinListMethod(List<Customer> customerList, List<Order> orderList)
{
    return customerList.Join(
            orderList,
            customer => customer.Id,
            order => order.CustomerId,
            (customer, order) => customer
        ).Distinct().ToList();
}
Aquí, hacemos un inner join entre dos listas, customerList y orderList. El método usa LINQ para combinar las listas a partir de claves coincidentes: la propiedad Id de cada Customer de customerList y la propiedad CustomerId de cada Order de orderList. El resultado del join es una secuencia de elementos emparejados, en la que cada par está formado por un Customer y el Order correspondiente.
El selector de resultados (customer, order) => customer indica que solo se incluye en el resultado final la parte Customer de cada par. Después, usamos el método Distinct() para garantizar que cada Customer aparezca una sola vez en el resultado, con lo que se eliminan los duplicados.
Por último, el resultado se convierte en una List<Customer> con el método ToList().
Usar HashSet para comparar las listas
La siguiente solución usa el conjunto HashSet y lo aprovecha para obtener el resultado que buscamos:
public static List<Customer> HashSetMethod(List<Customer> customerList, List<Order> orderList)
{
    var customerIds = orderList.Select(i => i.CustomerId).ToHashSet();

    return customerList.Where(i => customerIds.Contains(i.Id)).ToList();
}
Esta vez, creamos una colección HashSet, customerIds, que contiene los valores únicos de CustomerId que extraemos de orderList. El HashSet garantiza que solo incluimos valores distintos, lo que permite comprobaciones de pertenencia eficientes.
A continuación, el método filtra customerList con el método Where(). Solo incluye en el resultado los clientes cuyo Id está en el HashSet customerIds. Por último, convertimos el resultado en una List<Customer> con el método ToList().
¿Cómo encontrar la diferencia entre dos listas?
Con ExceptBy, que, según la referencia de LINQ de Microsoft, produce “la diferencia de conjuntos de dos secuencias según una función de selector de clave especificada”.
Aquí importa lo que lo distingue de Except. Except compara elementos completos, así que dos objetos Customer con el mismo Id siguen siendo distintos a menos que el tipo sobrescriba (override) la igualdad. ExceptBy recibe las claves que hay que excluir y un selector para nuestra propia clave, así que compara por Id y no tiene en cuenta el resto del objeto.
Responde en un solo sentido cada vez. customers.ExceptBy(orderedIds, c => c.Id) nos da los clientes sin pedidos; si intercambiamos los argumentos, obtenemos los pedidos sin cliente correspondiente, uno por cada CustomerId, ya que ExceptBy solo conserva el primer elemento de cada clave. Para obtener la diferencia completa en los dos sentidos, hay que ejecutarlo dos veces y quedarse con ambos resultados.
El argumento de rendimiento es el mismo de antes: ExceptBy construye internamente un conjunto con las claves, así que hace una sola pasada por cada lista en lugar de un recorrido por elemento.
ExceptBy está disponible en System.Linq desde .NET 6, .NET 10 incluido, así que no necesita ningún paquete ni método auxiliar:
var orderedIds = orders.Select(o => o.CustomerId);

var customersWithoutOrders = customers.ExceptBy(orderedIds, c => c.Id).ToList();
Si necesitamos comparar objetos completos en lugar de una sola clave, nuestro artículo sobre el método Except de LINQ trata ese caso en detalle. Y cuando solo queremos una respuesta de sí o no en lugar de una lista, comprobar si los elementos de una lista existen en otra es una tarea más pequeña.
Ebook gratis
¿Tu Web API está lista para producción?
33 puntos que comprobar antes de desplegarla, con la solución de cada uno. Un PDF gratuito de 76 páginas para .NET 10.
El ebook está en inglés.
Descarga la checklist gratisPDF gratuito. Un solo correo para enviártelo. Puedes darte de baja cuando quieras.
Ahora, comparemos nuestros cinco métodos de búsqueda de coincidencias con una serie de benchmarks.
Preparación del benchmark
Pasamos a evaluar estos métodos con un benchmark, en términos de eficiencia y velocidad. Añadamos el paquete BenchmarkDotNet con dotnet add package BenchmarkDotNet, empecemos el archivo de la clase de benchmark con using BenchmarkDotNet.Attributes; y preparemos en esa clase dos métodos auxiliares para nuestro caso de prueba, que mide el rendimiento al comparar listas:
private List<Customer>? _customers;
private List<Order>? _orders;

[GlobalSetup]
public void GlobalSetup()
{
    var numberOfCustomers = 10000;
    var numberOfOrders = 500000;

    _customers = GenerateRandomCustomers(numberOfCustomers).ToList();
    _orders = GenerateRandomOrders(numberOfOrders, _customers).ToList();
}

private static IEnumerable<Customer> GenerateRandomCustomers(int count)
{
    return Enumerable.Range(1, count)
        .Select(i => new Customer
        {
            Id = i,
            Firstname = $"CustomerFirstname{i}",
            Surname = $"CustomerSurname{i}"
        });
}

private static IEnumerable<Order> GenerateRandomOrders(int count, List<Customer> customers)
{
    var random = new Random();

    return Enumerable.Range(1, count)
        .Select(i => new Order
        {
            OrderId = i,
            CustomerId = random.Next(1, customers.Count + 1)
        });
}
En la clase de benchmark, el método GlobalSetup() prepara los datos que necesitamos para las evaluaciones de rendimiento. Lo marcamos con el atributo [GlobalSetup] para que se ejecute una vez antes de cada método de benchmark.
Dentro de él, inicializamos _customers y _orders con conjuntos de datos realistas y aleatorios. En concreto, usamos el método GenerateRandomCustomers() para crear una lista de 10 000 clientes, cada uno con un ID, un nombre y un apellido únicos. Después, rellenamos la lista _orders con el método GenerateRandomOrders(), que genera 500 000 pedidos con OrderIds únicos y asocia cada pedido a un cliente seleccionado al azar de la lista _customers.
El método GenerateRandomCustomers() se encarga de crear una secuencia de objetos Customer a partir del número indicado. Con Enumerable.Range() generamos una secuencia de enteros y usamos el método Select() para crear un nuevo objeto Customer por cada entero, lo que garantiza Ids distintos.
Del mismo modo, el método GenerateRandomOrders() genera una secuencia de objetos Order aleatorios a partir del número deseado y de la lista de clientes. Con Enumerable.Range() y el método Select(), creamos objetos Order y asignamos a la propiedad CustomerId de cada pedido un valor seleccionado al azar entre 1 y el número total de clientes. Así establecemos una asociación válida entre pedidos y clientes.
Juntos, estos métodos auxiliares nos permiten crear un conjunto de datos realista para medir el rendimiento de métodos diseñados para comparar y filtrar listas de clientes y pedidos según una propiedad concreta.
Resultados de la evaluación
Analicemos los resultados del benchmark:
| Method         | Mean         | Error        | StdDev     | Rank | Gen0      | Allocated   |
|--------------- |-------------:|-------------:|-----------:|-----:|----------:|------------:|
| HashSetMethod  |     16.02 ms |     3.303 ms |   0.858 ms |    1 |         - |   732.91 KB |
| JoinListMethod |     52.06 ms |    55.950 ms |  14.530 ms |    2 | 1000.0000 | 13302.52 KB |
| JoinMethod     |     80.63 ms |     7.172 ms |   1.862 ms |    3 |         - |   440.88 KB |
| WhereAnyMethod |     84.47 ms |    11.028 ms |   2.864 ms |    4 |         - |   440.93 KB |
| ForEachMethod  | 24,058.62 ms | 3,555.263 ms | 923.291 ms |    5 |         - |   256.41 KB |
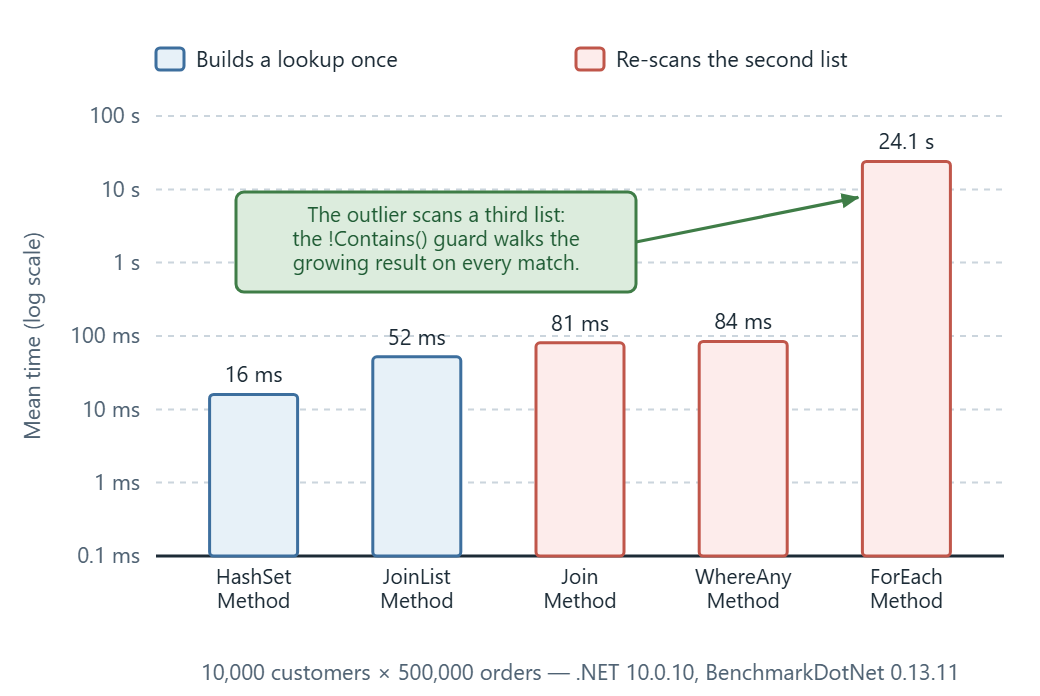
HashSetMethod() es el más rápido, con 16 ms, y lo es por una razón estructural y no por una microoptimización: proyecta una sola vez las claves de los pedidos en un HashSet y después responde a cada pregunta de pertenencia en tiempo constante. Su costo crece con la suma de las longitudes de las dos listas, no con su producto. JoinListMethod() queda segundo, con 52 ms, y funciona de la misma manera, porque Join() construye una tabla de búsqueda sobre la secuencia interna antes de empezar a emparejar. Eso sí, paga por la tabla de búsqueda que construye sobre los 500 000 pedidos, y de ahí salen los 13 MB de memoria que asigna.
JoinMethod(), con 80.63 ms, y WhereAnyMethod(), con 84.47 ms, quedan a menos de un 5 % el uno del otro, y no es casualidad: son el mismo filtro Where más Any, escrito en sintaxis de consulta y en sintaxis de método, así que los dos vuelven a recorrer orderList para cada cliente. ForEachMethod() es aproximadamente 285 veces más lento todavía, con algo más de 24 segundos, porque su bucle interno nunca se detiene en la primera coincidencia, así que lee los 500 000 pedidos para cada cliente. Además, su comprobación con !customersWithOrders.Contains(customer) recorre la lista de resultados, cada vez más larga, en cada coincidencia. Medido en .NET 10.0.10 con BenchmarkDotNet 0.13.11, en una ejecución en modo Monitoring de cinco iteraciones.
¿Qué método conviene usar para comparar dos listas?
Usa el enfoque con HashSet. En el benchmark anterior, termina en 16 milisegundos, mientras que el foreach anidado tarda 24 segundos: el mismo trabajo, con tres órdenes de magnitud de diferencia.
En realidad, la clasificación no trata de cinco técnicas, sino de dos algoritmos. HashSetMethod y JoinListMethod construyen una tabla de búsqueda una sola vez y la consultan, lo que los coloca en los dos primeros puestos. WhereAnyMethod y JoinMethod vuelven a recorrer la segunda lista para cada elemento de la primera, y por eso quedan a menos de un 5 % el uno del otro y pierden cada vez más terreno a medida que crecen las listas.
ForEachMethod es un caso aparte, no un tercer miembro de ese grupo. Lee todos los pedidos para cada cliente en lugar de detenerse en la primera coincidencia, y su comprobación de duplicados también recorre la lista de resultados. Tarda unas 285 veces más que el siguiente más lento.
Conviene conocer Join por otro motivo. Devuelve pares, así que, cuando necesitamos el pedido coincidente junto con el cliente, es el único de los cuatro métodos LINQ que nos da ambos.
| Lo que necesitamos | Qué usar | Forma |
|---|---|---|
| Elementos de A que también existen en B, emparejados por una clave | HashSet con las claves de B y después Where | var keys = b.Select(x => x.Key).ToHashSet(); |
| Elementos de A que no existen en B | ExceptBy | a.ExceptBy(b.Select(x => x.Key), x => x.Key) |
| Elementos de B que no existen en A | ExceptBy, con los argumentos intercambiados | Cada llamada conserva un elemento por clave; ejecútalo en los dos sentidos para obtener la diferencia completa |
| Las dos listas emparejadas por la clave | Join | Devuelve los pares, no solo un lado |
| Si las dos listas contienen los mismos elementos, en el mismo orden | SequenceEqual | Igualdad de elementos, tiene en cuenta el orden |
| Si las dos listas contienen los mismos elementos, en cualquier orden | HashSet.SetEquals | Ignora el orden y los duplicados |
| Listas pequeñas, comparación de objetos completos | Cualquiera de los anteriores | Por debajo de unos cientos de elementos, la diferencia es muy inferior a un milisegundo |
Conclusión
Hemos visto cinco formas de emparejar dos listas por una sola propiedad, y el benchmark las separa en dos algoritmos en lugar de cinco técnicas: construir una tabla de búsqueda una sola vez o volver a recorrer la segunda lista por cada elemento. El enfoque con HashSet es el que conviene usar; Join(), cuando necesitamos los dos lados de la coincidencia, y ExceptBy, cuando la pregunta es la diferencia y no las coincidencias.
El mismo razonamiento basado en claves se aplica directamente a comparar dos diccionarios, donde la tabla de búsqueda ya nos viene construida.
Probado con .NET 10.0.10.