XPath es un lenguaje de rutas para XML, y .NET lo expone mediante dos métodos de XmlNode: SelectSingleNode() devuelve el primer nodo que coincide con una expresión y SelectNodes() devuelve todos los que coinciden.
Una expresión se lee como la ruta de un archivo. /catalog/book baja desde la raíz, //book encuentra libros a cualquier profundidad y un predicado entre corchetes filtra lo que devolvió un paso, como en /catalog/book[price<50.00].
Introducción a XML
XML (eXtensible Markup Language), como indica su nombre, es un lenguaje de marcado. Usa una organización jerárquica para describir y almacenar datos.
Otra característica del lenguaje XML es que no tiene etiquetas predefinidas: los usuarios crean las suyas. Además, el número de etiquetas es ilimitado. Así, XML es flexible y sirve para describir cualquier tipo de información.
Sintaxis de XML
Un documento XML tiene un modelo jerárquico formado por un elemento raíz, el elemento de nivel superior, y sus ramas.
Podemos definir un elemento como todo lo que hay entre una etiqueta de apertura (<tagName>) y su etiqueta de cierre correspondiente (</tagName>), ambas incluidas, y cada uno de estos bloques puede contener texto, atributos o incluso otros elementos anidados:
<?xml version="1.0" encoding="utf-8" ?>
<catalog>
  <book id="1">
    <author>King, Stephen</author>
    <title>IT</title>
    <genre>Horror</genre>
    <price>40.00</price>
  </book>
  <book id="2">
    <author>Assis, Machado De</author>
    <title>Dom Casmurro</title>
    <genre>Romance</genre>
    <price>50.00</price>
  </book>
  <book id="3">
    <author>Calaprice, Alice; Lipscombe, Trevor</author>
    <title>Albert Einstein: A Biography</title>
    <genre>Biography</genre>
    <price>30.00</price>
  </book>
  <book id="4" xmlns="urn:example-schema">
    <author>Fowler, Martin; Beck, Kent</author>
    <title>Refactoring: Improving the design of existing code</title>
    <genre>Scientific</genre>
    <price>60.00</price>
  </book>
</catalog>
En este ejemplo, tenemos un archivo XML que representa un catálogo de books, donde catalog es el elemento raíz y contiene toda la información que vamos a manejar.
El author, el title, el genre y el price de cada libro se representan con elementos anidados dentro de la etiqueta padre book. Esta estructura usa un atributo para definir el índice de cada book.
Los elementos de nivel inferior, como author, representan su valor con texto, una cadena situada entre sus etiquetas de apertura y de cierre.
¿Qué es XPath y qué versión admite .NET?
XPath es un lenguaje de consulta para XML. Una expresión describe una ruta a través del árbol del documento, y .NET la evalúa sobre un documento cargado y devuelve los nodos que coincidan.
La sintaxis se lee como la ruta de un archivo. Una / inicial empieza en la raíz, // busca a cualquier profundidad, un nombre baja un nivel y @ llega a un atributo. Los corchetes contienen un predicado que filtra lo que haya devuelto el paso que tienen delante.
.NET implementa XPath 1.0, y solo XPath 1.0. La referencia de Microsoft de SelectNodes() cita la recomendación XPath 1.0 del W3C, y las extensiones de LINQ to XML describen el orden de sus resultados según esa misma recomendación.
Todo lo que añadieron XPath 2.0 y 3.1 simplemente no existe. upper-case(), matches(), el operador except y las expresiones if/then/else lanzan una XPathException. El mensaje de una función inexistente culpa a un administrador de espacios de nombres en lugar de a la versión, lo que lleva a buscar un problema completamente distinto.
Estas expresiones se parecen a las que usamos para navegar por las carpetas de un sistema operativo, lo que hace que XPath resulte familiar a cualquiera que empiece a trabajar con él. La mayoría de las expresiones de este artículo se construyen con esas piezas:
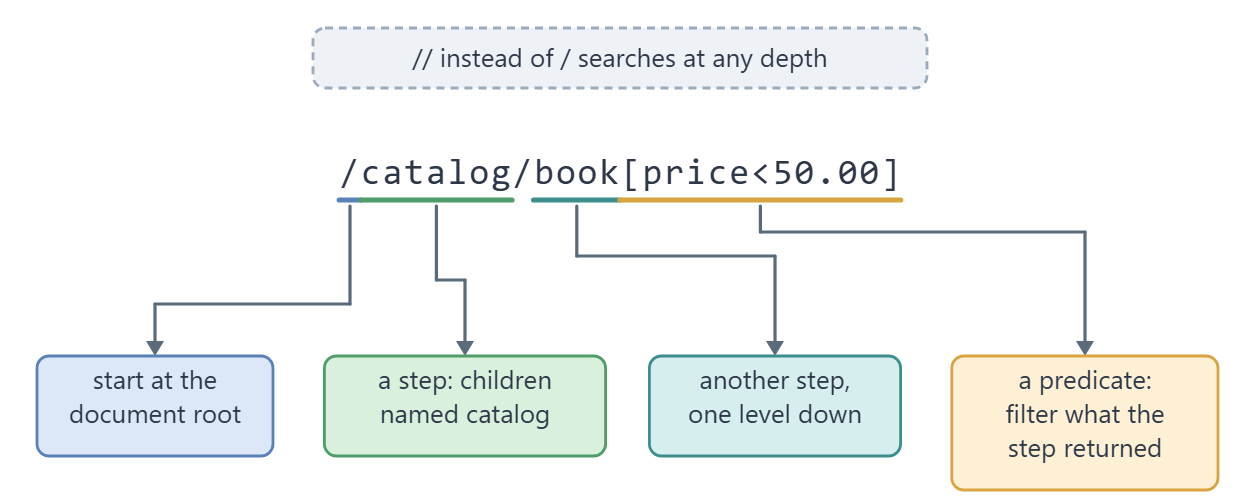
Esto es lo que selecciona un puñado de expresiones y cuántos nodos devuelve cada una sobre el catálogo anterior:
| Expresión de ejemplo | Qué selecciona | Sobre el catálogo de ejemplo |
|---|---|---|
/catalog | el elemento raíz catalog | 1 nodo |
/catalog/book | cada hijo book de catalog que no está en ningún espacio de nombres | 3 de los 4 libros |
/catalog/book[1] | el primer hijo book de catalog | 1 nodo |
/catalog/book[last()] | el último de esos book | 1 nodo |
/catalog/book[@id='3'] | el book cuyo atributo id es 3 | 1 nodo |
/catalog/book[price<50.00] | cada uno de esos book con precio inferior a 50.00 | 2 nodos |
/catalog/book[price>10.00]/author | el author de cada uno de esos book con precio superior a 10.00 | 3 nodos |
//book | cada book a cualquier profundidad, igualmente sin espacio de nombres | 3 nodos |
//book/@id | el atributo id de cada uno de ellos | 3 nodos |
//catalog/*[local-name()='book'] | cada hijo book, sea cual sea su espacio de nombres | los 4 libros |
En resumen, las expresiones XPath nos permiten combinar distintos criterios para seleccionar un nodo o un conjunto de nodos. Los fragmentos entre corchetes se llaman predicados.
Creación y configuración del proyecto
Para entender cómo funciona XPath en la práctica, vamos a crear un proyecto para probar distintas formas de navegar por un archivo XML.
Como es un proyecto de ejemplo sencillo, vamos a crear un proyecto de consola de .NET simple. Si lo que necesitamos es generar el documento en lugar de leerlo, el artículo sobre cómo crear archivos XML en C# explica esa parte del trabajo.
Agregar el archivo XML al proyecto
Primero, creemos el archivo XML agregando un archivo nuevo llamado BooksCatalog.xml en una carpeta Resources junto a la carpeta del proyecto. Después, tomemos el código anterior con los libros de ejemplo y peguémoslo en este archivo.
Una vez creado, tenemos que configurar el archivo XML para que se copie en la carpeta de salida al compilar la aplicación. En lugar de configurarlo en las propiedades del archivo dentro de un IDE concreto, vamos a declararlo en el archivo de proyecto, que se comporta igual en Visual Studio, Rider, Visual Studio Code y la línea de comandos:
<ItemGroup>
  <Content Include="..\Resources\BooksCatalog.xml" Link="BooksCatalog.xml">
    <CopyToOutputDirectory>Always</CopyToOutputDirectory>
  </Content>
</ItemGroup>
El valor Always reemplaza el archivo XML en la carpeta de salida en cada compilación, lo que garantiza que la aplicación siempre maneje los datos más recientes del catálogo.
Ebook gratis
¿Tu Web API está lista para producción?
33 puntos que comprobar antes de desplegarla, con la solución de cada uno. Un PDF gratuito de 76 páginas para .NET 10.
El ebook está en inglés.
Descarga la checklist gratisPDF gratuito. Un solo correo para enviártelo. Puedes darte de baja cuando quieras.
¿En qué se diferencian SelectSingleNode() y SelectNodes()?
SelectSingleNode() devuelve el primer nodo que coincide con una expresión, como un único XmlNode. SelectNodes() los devuelve todos, como un XmlNodeList. Esa es la principal diferencia de comportamiento entre los dos.
Ambos están declarados en XmlNode y no en XmlDocument, así que podemos llamar a cualquiera de los dos sobre el documento, sobre el elemento de documento o sobre cualquier nodo más abajo en el árbol.
El nodo sobre el que los llamemos se convierte en el nodo de contexto, el punto de partida de una expresión relativa. Desde el elemento catalog, book significa “los hijos book de este elemento”.
Una expresión que empieza por / o por // ignora el nodo de contexto y parte, en cambio, del documento. Todas las expresiones que nuestro código ejecuta desde el elemento raíz empiezan por //, así que el root que vamos pasando de un método a otro no cambia ninguno de estos resultados.
Ambos métodos tienen además una sobrecarga que acepta un segundo argumento, un XmlNamespaceManager, que necesitaremos en el apartado siguiente.
| Método | Declarado en | Devuelve | Si no hay coincidencias |
|---|---|---|---|
SelectSingleNode() | XmlNode | XmlNode?, la primera coincidencia | null |
SelectNodes() | XmlNode | XmlNodeList?, todas las coincidencias | una lista vacía, Count 0 |
XPathSelectElement() | XNode, método de extensión | XElement?, la primera coincidencia | null |
XPathSelectElements() | XNode, método de extensión | IEnumerable<XElement>, todas las coincidencias | una secuencia vacía, nunca null |
XPathEvaluate() | XNode, método de extensión | object: un double, un string, un bool o una secuencia de nodos | depende de la expresión |
XPathNavigator.Select() | XPathNavigator | XPathNodeIterator | un iterador con Count 0 |
Antes de empezar a leer datos concretos del archivo, veamos qué tenemos que hacer para cargarlo en memoria:
using System.Xml;
using System.Xml.Linq;

var path = Path.Combine(AppContext.BaseDirectory, "BooksCatalog.xml");

var doc = new XmlDocument();
doc.Load(path);
var root = doc.DocumentElement!;
Creamos una instancia de la clase XmlDocument para representar los datos en memoria. Después, pasamos la ruta del archivo como argumento al método Load(), que carga el documento indicado. Construimos esa ruta a partir de AppContext.BaseDirectory para que apunte a la copia que está junto al ejecutable, y eso es lo que permite que el ejemplo se ejecute con dotnet run además de desde un IDE.
Además, accedemos al elemento base mediante la propiedad DocumentElement y lo guardamos en una nueva variable, root. Esa propiedad está declarada como anulable, y el operador ! que permite valores null (null-forgiving) afirma algo que aquí podemos demostrar: un documento bien formado que se acaba de cargar tiene un elemento de documento. Delante de SelectSingleNode(), como veremos, el mismo operador ocultaría un valor que de verdad puede ser null.
Ya podemos hacer consultas sobre los datos. A partir de aquí, todos los métodos van dentro de una clase estática, que declaramos en Program.cs debajo del código de carga. Así que vamos a crear un método que se encargue de las consultas:
public static string? SelectSingleBook(XmlNode root)
{
    var node = root.SelectSingleNode("//catalog/book[position()=2]");

    return node is null ? null : FormatXml(node.OuterXml);
}
El método SelectSingleBook() recibe el elemento raíz como parámetro y consulta el libro que ocupa la segunda posición del catálogo. Devuelve null cuando la consulta no encuentra nada, y por eso su tipo de valor devuelto es string?. Sin embargo, la propiedad OuterXml, que contiene toda la información del elemento seleccionado, representa los datos en una sola línea. Antes de incorporar una expresión como esta al código, el XPath Tester te permite pegar tu XML y probarla para ver exactamente qué nodos selecciona.
Para que el texto quede más legible, como en el archivo de ejemplo, tenemos que crear un método que le dé formato:
public static string FormatXml(string unformattedXml)
{
    return XElement.Parse(unformattedXml).ToString();
}
El string que devuelve el método FormatXml() se mostrará después en la consola con toda la información del elemento:
Selected book:
<book id="2">
  <author>Assis, Machado De</author>
  <title>Dom Casmurro</title>
  <genre>Romance</genre>
  <price>50.00</price>
</book>
A continuación, vamos a crear otro método para seleccionar un grupo de elementos:
public static List<string> SelectBooks(XmlNode root)
{
    var nodes = root.SelectNodes("//catalog/book[price<50.00]");

    if (nodes is null)
    {
        return [];
    }

    return nodes
        .Cast<XmlNode>()
        .Select(x => FormatXml(x.OuterXml))
        .ToList();
}
Del mismo modo, el método SelectBooks() recibe el elemento raíz como parámetro. Pero esta vez consultamos todos los elementos cuyo price es inferior a 50.00.
Una vez obtenido el resultado de la consulta (un objeto XmlNodeList), lo convertimos en una lista de cadenas que contiene el OuterXml con formato de cada elemento. El compilador considera que SelectNodes() devuelve una lista anulable, así que en ese caso devolvemos una lista vacía en lugar de silenciar la advertencia con !.
Por último, se devuelve el resultado y se imprime en la consola:
Selected books:
<book id="1">
  <author>King, Stephen</author>
  <title>IT</title>
  <genre>Horror</genre>
  <price>40.00</price>
</book>
<book id="3">
  <author>Calaprice, Alice; Lipscombe, Trevor</author>
  <title>Albert Einstein: A Biography</title>
  <genre>Biography</genre>
  <price>30.00</price>
</book>
¿Cómo consultar XML que usa espacios de nombres?
En otras situaciones, nos encontramos con modelos XML que contienen espacios de nombres. La idea de los espacios de nombres es permitir que las aplicaciones manejen o validen los elementos de forma distinta, aunque tengan el mismo nombre.
Por suerte, el lenguaje XPath también admite espacios de nombres en la ruta. Como se ve en el ejemplo, el último libro del catálogo tiene un atributo más que indica un espacio de nombres:
<book id="4" xmlns="urn:example-schema">
La referencia de Microsoft de XmlNode.SelectNodes() enuncia la regla que decide con qué coincide una expresión sin prefijo: “Si la expresión XPath no incluye un prefijo, se supone que el URI del espacio de nombres es el espacio de nombres vacío”. Por eso //book devuelve tres de nuestros cuatro libros y se salta el que declara un espacio de nombres predeterminado.
Ahora, vamos a crear el método de selección para consultar el libro que contiene el espacio de nombres:
public static List<string> SelectBooksUsingNamespaces(XmlDocument doc)
{
    var nsmgr = new XmlNamespaceManager(doc.NameTable);
    nsmgr.AddNamespace("ex", "urn:example-schema");

    var nodes = doc.SelectNodes("descendant::ex:book", nsmgr);

    if (nodes is null)
    {
        return [];
    }

    return nodes
        .Cast<XmlNode>()
        .Select(x => FormatXml(x.OuterXml))
        .ToList();
}
Como vemos, el método SelectBooksUsingNamespaces() recibe un XmlDocument como parámetro, mientras que los otros dos métodos reciben un XmlNode. Es así por comodidad: XmlNamespaceManager necesita un XmlNameTable, y la propiedad NameTable está en XmlDocument, al que se llega desde un nodo a través de OwnerDocument. A continuación, al principio de la función, creamos una instancia de XmlNamespaceManager con los datos que llegan en la variable del argumento.
Ebook gratis
¿Tu Web API está lista para producción?
33 puntos que comprobar antes de desplegarla, con la solución de cada uno. Un PDF gratuito de 76 páginas para .NET 10.
El ebook está en inglés.
Descarga la checklist gratisPDF gratuito. Un solo correo para enviártelo. Puedes darte de baja cuando quieras.
Después, el método AddNamespace() crea una asociación con el espacio de nombres esperado. Luego, ejecutamos el método SelectNodes(), pero ahora usamos la variable nsmgr además de la expresión de consulta.
Por último, convertimos el resultado antes de devolverlo. Así, el resultado del método se imprime en la consola:
Selected books:
<book id="4" xmlns="urn:example-schema">
  <author>Fowler, Martin; Beck, Kent</author>
  <title>Refactoring: Improving the design of existing code</title>
  <genre>Scientific</genre>
  <price>60.00</price>
</book>
¿Qué ocurre cuando una consulta XPath no encuentra nada?
Los dos métodos responden de forma distinta, y esa diferencia puede ser el origen de las NullReferenceException en el código que trabaja con XML.
SelectSingleNode() devuelve null. No hay ningún nodo vacío que devolver, así que quien llama tiene que comprobarlo antes de usar OuterXml o InnerText.
SelectNodes(), en cambio, devuelve un XmlNodeList vacío. Si ejecutamos //catalog/book[price>1000] sobre nuestro catálogo, obtenemos una lista con un Count de 0, así que un foreach sobre ella no hace nada y no se lanza ninguna excepción. No encontrar coincidencias es un resultado normal para ambos métodos, nunca un error, así que ninguno de los dos lanza una excepción al devolverlo.
Ambos métodos se declaran con tipos de valor devuelto anulables, XmlNode? y XmlNodeList?, y por eso, con los tipos de referencia anulables activados, el compilador espera comprobaciones de null o el operador ! que permite valores null.
Vale la pena ser honestos con ese operador. Silencia al compilador, pero no hace que un valor deje de ser null. Delante de SelectSingleNode(), oculta un fallo real, así que ahí sí está justificada una comprobación de null.
Una consulta que no encuentra nada no es un error, así que la comprobación va en nuestro código y no en un bloque try:
var node = root.SelectSingleNode("//catalog/book[price>1000]");

if (node is null)
{
    Console.WriteLine("No book matched the query.");
    return;
}

Console.WriteLine(FormatXml(node.OuterXml));
Fíjate en que aquí nada captura una excepción. SelectSingleNode() devuelve null en lugar de lanzar una excepción, y el if es todo el manejo que hace falta.
¿Cómo ejecutar XPath sobre un XDocument?
XDocument es el tipo de documento de LINQ to XML, y XPath llega a él mediante métodos de extensión, no mediante métodos de instancia. Están en el espacio de nombres System.Xml.XPath, así que la directiva using tiene que estar presente o los métodos no aparecerán nunca en el tipo.
XPathSelectElement() devuelve el primer XElement que coincide, o null. XPathSelectElements() devuelve un IEnumerable<XElement> que está vacío, nunca null, cuando no hay coincidencias. XPathEvaluate() se encarga de las expresiones que devuelven algo distinto de nodos, así que count(//book) se obtiene como un double.
Las expresiones son el mismo XPath 1.0, y la regla de los espacios de nombres también es la misma. Una sobrecarga de cada método acepta un IXmlNamespaceResolver, y XmlNamespaceManager implementa esa interfaz, así que un mismo administrador de espacios de nombres sirve para ambas API. Los elementos se devuelven en el orden del documento, algo que garantizan los métodos de extensión y no la recomendación en sí.
Usa estos métodos cuando el código que los rodea ya sea LINQ to XML y una consulta concreta se lea mejor como una ruta que como una cadena de llamadas a Elements().
Si lo que necesitas es leer un documento en lugar de consultarlo, el artículo sobre cómo leer documentos XML en C# explica la parte de la carga, y el de LINQ to XML trata la sintaxis de consulta junto a la que se sitúan estos métodos de extensión.
El mismo predicado que usamos con SelectNodes(), esta vez sobre un XDocument:
public static List<string> SelectBooksWithLinqToXml(XDocument doc)
{
    return doc
        .XPathSelectElements("//catalog/book[price<50.00]")
        .Select(x => x.ToString())
        .ToList();
}
Fíjate en que no hay ningún !: XPathSelectElements() devuelve una secuencia no anulable, así que el compilador no tiene nada de qué quejarse.
Esta es su salida en la consola, obtenida al ejecutar el proyecto:
Selected books with LINQ to XML:
<book id="1">
  <author>King, Stephen</author>
  <title>IT</title>
  <genre>Horror</genre>
  <price>40.00</price>
</book>
<book id="3">
  <author>Calaprice, Alice; Lipscombe, Trevor</author>
  <title>Albert Einstein: A Biography</title>
  <genre>Biography</genre>
  <price>30.00</price>
</book>
Conclusión
XPath nos da una sola cadena que describe exactamente qué nodos queremos, y .NET nos lo ofrece mediante SelectSingleNode() para la primera coincidencia y SelectNodes() para todas, o mediante XPathSelectElement() y XPathSelectElements() cuando ya estamos trabajando con un XDocument.
Hay dos cosas que confunden a mucha gente, y vale la pena recordar ambas: .NET solo habla XPath 1.0, y un nombre sin prefijo en una expresión significa “sin espacio de nombres”, así que un documento con un espacio de nombres predeterminado necesita un XmlNamespaceManager y un prefijo, o una prueba con local-name(). Cuando no compensa recorrer los nodos a mano, deserializar todo el documento en objetos es la otra forma de leerlo.
Probado con .NET 10.0.10.