Uma quebra de linha em C# não é um único caractere. Ela pode ser qualquer uma de sete sequências, e ReplaceLineEndings() é o único método que reconhece todas elas: text.ReplaceLineEndings("\n") normaliza uma string com finais de linha misturados em uma única chamada.
String.Replace() e Regex.Replace() também resolvem, mas só para as sequências que nós mesmos indicamos, e só na ordem certa. Qual dos três usar depende de sabermos ou não o que há no texto.
O que conta como quebra de linha em C#?
Uma quebra de linha em C# não é um único caractere, mas qualquer uma de sete sequências, e quais delas precisamos tratar depende inteiramente da origem do texto.
Três delas aparecem no código do dia a dia. O avanço de linha (line feed), escrito \n, é U+000A e é o que o Unix, o Linux e o macOS moderno escrevem. O retorno de carro (carriage return), \r, é U+000D. O par retorno de carro e avanço de linha, \r\n, é o que o Windows escreve, e conta como uma quebra, e não como duas.
Outras quatro são mais raras e aparecem em textos que vieram de outro lugar: avanço de página (form feed) em U+000C, próxima linha (next line) em U+0085, separador de linha em U+2028 e separador de parágrafo em U+2029.
Environment.NewLine é a sequência que a plataforma atual escreve. Ela retorna "\r\n" no Windows e "\n" no Linux e no macOS, o que faz dela o valor certo para escrever e o valor errado para procurar.
Todo o problema está nessa diferença. A escrita precisa de uma sequência. A leitura precisa sobreviver às sete.
Finais de linha misturados são o caso normal, e não um caso extremo: um arquivo escrito no Windows, uma string retornada por um serviço Linux e um texto colado em um formulário web podem acabar todos na mesma variável. A leitura de arquivos é de onde costumam vir os finais de linha misturados, e qualquer código que precise contar as linhas de um arquivo tem de definir o que é uma quebra de linha antes de começar a contar.
Como substituir quebras de linha com String.Replace()?
String.Replace() troca todas as ocorrências de uma substring por outra e retorna uma nova string. Substituir as quebras de linha por \n significa chamá-lo duas vezes, e a ordem em que as duas chamadas são executadas decide se o resultado sai certo.
Substituímos \r\n primeiro e depois \r. Inverter essa ordem quebra o par do Windows: substituir \r sozinho deixa intacto o \n que vem depois dele, então cada quebra de linha do Windows vira dois avanços de linha em vez de um.
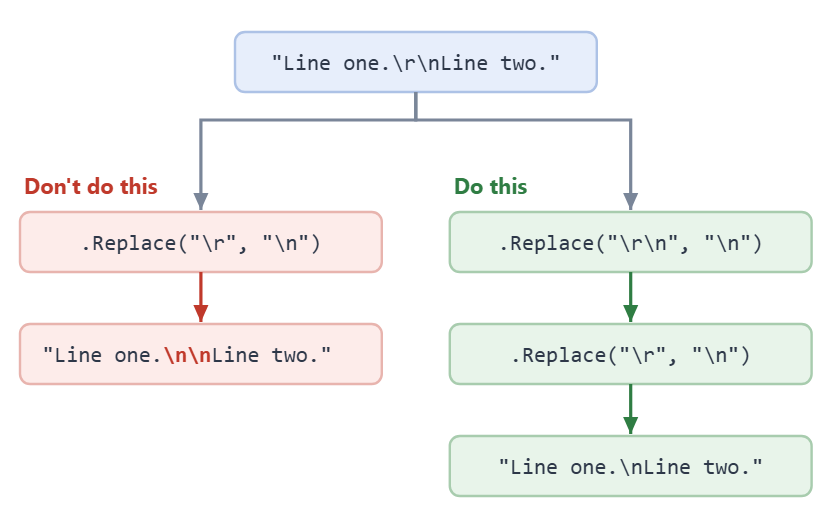
O método é uma simples busca por substring. Ele não sabe nada sobre quebras de linha, então só encontra as sequências que indicamos, e nada mais. As quatro sequências mais raras passam direto, assim como qualquer sequência que esquecermos.
Replace() retorna a instância original da string quando não encontra nenhuma ocorrência, então uma chamada sem ocorrências não aloca nada. Vale saber disso antes de ler qualquer benchmark que meça esse encadeamento em um texto com um único tipo de quebra de linha.
Ele é a escolha quando sabemos exatamente o que há no texto.
Este é o encadeamento na ordem correta:
const string text = "Line one.\r\nLine two.\nLine three.\rLine four.";
var newText = text.Replace("\r\n", "\n").Replace("\r", "\n");
A string de teste contém as três sequências comuns, então as duas chamadas têm o que fazer. Isso nos dá o resultado:
Line one.\nLine two.\nLine three.\nLine four.
Inverter as duas chamadas transformaria o primeiro \r\n em \n\n e deixaria a string com uma linha a mais do que tinha no início.
Como substituir quebras de linha com ReplaceLineEndings()?
ReplaceLineEndings() chegou no .NET 6 e continua atual no .NET 10. Ele substitui todas as sequências de nova linha pelo texto que passamos. Uma única chamada e nenhuma ordem para errar.
Ele reconhece sete sequências do Padrão Unicode: retorno de carro, avanço de linha, os dois juntos como par, próxima linha, avanço de página, separador de linha e separador de parágrafo. O par conta como uma única quebra, e é por isso que uma quebra de linha do Windows nunca é duplicada aqui, como pode acontecer com String.Replace().
A sobrecarga sem parâmetros substitui as sete por Environment.NewLine, o que normaliza um texto com finais de linha misturados para o que a plataforma escreve. É essa a chamada a usar quando o texto está prestes a ser gravado.
E-book gratuito
Sua Web API está pronta para produção?
33 itens para verificar antes de implantá-la, com a correção de cada um. Um PDF gratuito de 76 páginas para .NET 10.
O e-book está em inglês.
Baixe o checklist gratuitoPDF gratuito. Um único e-mail para enviá-lo. Cancele a inscrição quando quiser.
Passar "\n" segue um caminho dedicado no runtime, então normalizar para os finais de linha do Unix é o caso rápido, e não o geral.
Uma ressalva importa: nunca o use em um analisador de protocolo. O HTTP exige CRLF, e um método que trata U+2028 como quebra de linha é permissivo demais para esse trabalho.
Por exemplo, podemos normalizar tudo para o avanço de linha do Unix:
const string text = "Line one.\r\nLine two.\nLine three.\rLine four.";
var newText = text.ReplaceLineEndings("\n");
Uma única chamada trata o par do Windows, o retorno de carro isolado e o avanço de linha que já estava correto. Obtemos o resultado:
Line one.\nLine two.\nLine three.\nLine four.
A ressalva sobre analisadores de protocolo não é nossa. A referência de String.ReplaceLineEndings da Microsoft diz: “Não é recomendado que analisadores de protocolo utilizem esta API.”
A tabela lista todas as sequências que o método reconhece e o que cada uma das outras duas abordagens deste artigo faz com elas:
| Sequência | Ponto de código | Nome | Reconhecida por ReplaceLineEndings() | Reconhecida pelo encadeamento de Replace() | Reconhecida pela regex |
|---|---|---|---|---|---|
\n | U+000A | Avanço de linha (LF) | Sim | Não | Sim |
\r | U+000D | Retorno de carro (CR) | Sim | Sim | Sim |
\r\n | U+000D U+000A | CRLF, como uma única quebra | Sim | Sim | Sim |
\u0085 | U+0085 | Próxima linha (NEL) | Sim | Não | Não |
\f | U+000C | Avanço de página (FF) | Sim | Não | Não |
\u2028 | U+2028 | Separador de linha (LS) | Sim | Não | Não |
\u2029 | U+2029 | Separador de parágrafo (PS) | Sim | Não | Não |
Como substituir quebras de linha com uma expressão regular?
As expressões regulares permitem a correspondência precisa de padrões e a substituição de padrões de caracteres em strings. Isso faz do método Regex.Replace() uma escolha válida para tratar quebras de linha, embora raramente a melhor.
A forma idiomática atual é uma regex criada pelo gerador de código-fonte, declarada como um método parcial em uma classe parcial cujo arquivo começa com using System.Text.RegularExpressions;:
[GeneratedRegex(@"\r\n|\r|\n")]
private static partial Regex LineBreakRegex();
O padrão inclui as três sequências comuns e coloca \r\n primeiro, para que um par do Windows seja consumido como uma única correspondência, e não como duas. Depois, de dentro dessa classe, chamamos o método passando a string de entrada e o texto de substituição:
const string text = "Line one.\r\nLine two.\nLine three.\rLine four.";
var newText = LineBreakRegex().Replace(text, "\n");
Aqui, Regex.Replace() encontra as três sequências comuns de quebra de linha e reescreve cada uma como \n. As quatro sequências mais raras da tabela acima não estão no padrão, então passam intactas. E, de novo, obtemos o resultado:
Line one.\nLine two.\nLine three.\nLine four.
Uma expressão regular é a ferramenta certa quando a quebra de linha faz parte de um padrão maior que já estamos procurando de qualquer forma. Sozinha, ela não faz nada que os dois métodos acima já não façam, e costuma ser a mais cara de executar.
Qual método de substituição de quebras de linha usar?
O que decide isso, antes da velocidade, é a correção do resultado, e ela aponta para ReplaceLineEndings(). Ele reconhece as sete sequências, não tem regra de ordem para errar e o nome dele diz o que ele faz.
A velocidade já não o separa de String.Replace(). Em um parágrafo com finais de linha misturados, os dois ficam a cerca de dez nanossegundos um do outro e trocam de posição entre uma execução e outra, então nenhum deles é consistentemente mais rápido que o outro em nenhuma das duas entradas que medimos.
A alocação, sim, separa os dois no parágrafo misturado. O encadeamento de Replace() faz duas passagens e aloca uma string em cada uma, o dobro da memória da passagem única que ReplaceLineEndings() faz.
Regex.Replace() é, com folga, o mais lento dos três nas duas entradas, e não traz nenhuma vantagem quando a quebra de linha é tudo o que estamos procurando.
String.Replace() é a escolha quando sabemos exatamente quais sequências o texto contém e não queremos que mais nada seja alterado. Um texto que nós mesmos geramos é esse caso; um texto vindo de um usuário ou de uma API não é.
Para medir isso, usamos a biblioteca BenchmarkDotNet e executamos cada método sobre duas entradas: uma string curta com uma única quebra e um parágrafo com \r\n, \n e \r misturados:
[Params("Short", "Mixed")]
public string Input { get; set; } = "Short";

[GlobalSetup]
public void GlobalSetup() => _text = Input == "Short" ? ShortText : MixedText;

[Benchmark]
public string StringReplace() =>
    ReplaceLineBreak.ReplaceLineBreaksUsingTheStringReplaceMethod(_text);

[Benchmark]
public string StringReplaceLineEndings() =>
    ReplaceLineBreak.ReplaceLineBreaksUsingTheStringReplaceLineEndingsMethod(_text);

[Benchmark]
public string RegexReplace() =>
    ReplaceLineBreak.ReplaceLineBreaksUsingTheRegularExpressionReplaceMethod(_text);
O atributo [Params] executa o conjunto inteiro duas vezes, uma por entrada, então os dois casos ficam lado a lado em uma única tabela. A classe completa, com [MemoryDiagnoser], as duas strings de entrada e os métodos de ReplaceLineBreak que encapsulam as chamadas mostradas antes, está no código-fonte cujo link aparece no início do artigo. Agora podemos executar o benchmark e avaliar os resultados:
| Method                   | Input | Mean      | Error    | StdDev   | Gen0   | Gen1   | Allocated |
|------------------------- |------ |----------:|---------:|---------:|-------:|-------:|----------:|
| StringReplace            | Mixed | 213.71 ns | 4.150 ns | 4.613 ns | 0.2275 | 0.0002 |    1904 B |
| StringReplaceLineEndings | Mixed | 202.75 ns | 2.508 ns | 2.094 ns | 0.1137 |      - |     952 B |
| RegexReplace             | Mixed | 486.05 ns | 6.806 ns | 6.034 ns | 0.1135 |      - |     952 B |
| StringReplace            | Short |  33.16 ns | 0.717 ns | 1.158 ns | 0.0114 |      - |      96 B |
| StringReplaceLineEndings | Short |  32.69 ns | 0.411 ns | 0.384 ns | 0.0114 |      - |      96 B |
| RegexReplace             | Short |  98.23 ns | 0.892 ns | 0.745 ns | 0.0114 |      - |      96 B |
Na string curta, os dois métodos de String empatam em cerca de 33 ns e, no parágrafo misturado, empatam de novo em cerca de 200 a 215 ns. Essa ordem não é estável: em três execuções deste benchmark na mesma máquina, StringReplace ficou à frente de StringReplaceLineEndings na entrada misturada uma vez e atrás dele duas vezes, por margens menores que a variação entre as execuções. Nenhum dos dois métodos é significativamente mais rápido que o outro nessas duas entradas, e uma única execução pode colocar qualquer um deles na frente.
E-book gratuito
Sua Web API está pronta para produção?
33 itens para verificar antes de implantá-la, com a correção de cada um. Um PDF gratuito de 76 páginas para .NET 10.
O e-book está em inglês.
Baixe o checklist gratuitoPDF gratuito. Um único e-mail para enviá-lo. Cancele a inscrição quando quiser.
Na memória está a diferença de verdade. No parágrafo misturado, o encadeamento de Replace() aloca 1.904 bytes contra os 952 de ReplaceLineEndings(), exatamente o dobro, porque duas chamadas encadeadas criam duas strings, enquanto uma chamada cria uma só. Na string curta, os três alocam os mesmos 96 bytes, porque a primeira chamada do encadeamento não encontra nenhum \r\n e retorna a instância original sem alocar.
Regex.Replace() é o ponto fora da curva nas duas entradas: cerca de 2,3 a 2,4 vezes o custo de qualquer um dos métodos de String no parágrafo misturado e cerca de 3 vezes na string curta.
| Método | Reconhece | Armadilha de ordem | Quando usar |
|---|---|---|---|
ReplaceLineEndings() | As sete sequências | Nenhuma, uma única chamada | Não controlamos o texto, ou ele veio de um arquivo, de uma API ou de um usuário |
String.Replace() | Só as sequências que indicamos | Sim: substitua \r\n antes de \r | Sabemos exatamente quais sequências o texto contém e não queremos alterar nenhuma outra |
Regex.Replace() | Só o que o padrão inclui | Sim: a mesma ordem na alternância | A quebra de linha faz parte de um padrão maior que já estamos procurando |
Como remover quebras de linha em vez de substituí-las?
Passe uma string vazia. text.ReplaceLineEndings("") remove todas as sequências de nova linha e junta as linhas sem nada entre elas. Esse é um comportamento documentado, e não um efeito colateral de uma substituição vazia.
Mas o resultado costuma ficar ruim de ler. Duas frases que terminavam em linhas separadas se juntam em uma só, então substituir por um único espaço é a opção padrão mais útil: text.ReplaceLineEndings(" ") gera um texto que ainda dá para ler.
Remover quebras de linha não é o mesmo que remover espaços em branco. ReplaceLineEndings("") deixa cada tabulação, cada espaço e toda a indentação no início de cada linha exatamente onde estavam.
String.Replace() pode fazer o mesmo trabalho em duas chamadas, removendo \r e depois \n. A armadilha da ordem desaparece quando a substituição é vazia, já que as duas metades de um par do Windows são excluídas de qualquer forma, mas as quatro sequências mais raras continuam escapando.
Nenhuma das duas abordagens remove os espaços em branco das extremidades do resultado. Uma string que terminava em uma quebra de linha perde a quebra e mantém os espaços que vinham antes dela.
Em código, é uma única chamada:
const string text = "Line one.\r\nLine two.\nLine three.\rLine four.";
var newText = text.ReplaceLineEndings(string.Empty);
O que nos dá todas as linhas juntas:
Line one.Line two.Line three.Line four.
Se o que realmente queremos são as próprias linhas, e não uma única string longa, sai mais barato dividir o texto em linhas em vez de reescrever as quebras. E, se o objetivo for remover todos os caracteres de espaço em branco, e não só as quebras de linha, esse é outro trabalho, com outro método.
Conclusão
Neste artigo, substituímos quebras de linha em uma string em C# de três formas. A escolha padrão é ReplaceLineEndings(): ele reconhece as sete sequências de quebra de linha definidas pelo Padrão Unicode, trata um \r\n do Windows como uma quebra, e não duas, e precisa de uma única chamada, sem regra de ordem para lembrar.
String.Replace() é a escolha certa quando sabemos exatamente quais sequências o texto contém e não queremos que mais nada seja alterado. Ele só encontra o que indicamos, então precisamos indicar \r\n antes de \r, e aloca uma string a cada chamada que encontra uma ocorrência.
Regex.Replace() só compensa o custo quando a quebra de linha faz parte de um padrão maior que já estamos procurando. Sozinho, ele é com folga o mais lento dos três em textos curtos.
Remover quebras de linha não exige um método separado: ReplaceLineEndings("") exclui todas, e um único espaço costuma ser a substituição mais legível.
Testado com .NET SDK 10.0.302.